MADRS 作为临床终点:如何衡量变化
更新日期:2026 年 10 月 9 日
Montgomery–Åsberg 抑郁评定量表(MADRS)衡量特定的抑郁症状。 MADRS 临床终点是研究方案中定义的具体结果,例如从基线到第四周总分的变化。量表提供测量工具;研究方案规定结果及时间,而研究设计和分析决定如何解读结果。
本文介绍 MADRS 的十个条目、临床医生评分、自评形式,以及改善与缓解的区别。文中还提供评分计算示例、简单的治疗组比较,以及审慎阅读研究结果的清单。
你可以了解包含 10 个条目的 MADRS 评估,将其作为教育参考,而非临床评估。
示意场景;图中的图表和表格不是临床记录或评分说明。
MADRS 分数如何成为临床试验终点?
MADRS 是一项由临床医生评定的十条目抑郁症状严重程度量表,旨在检测随时间发生的变化。研究人员可以使用该量表的分数评估临床试验结果。
量表是测量工具;终点是研究方案中定义的具体结果和时间范围。
什么是预先设定的临床试验终点?
一项试验可能将主要终点定义为 MADRS 总分从基线到第四周的变化。这规定了:
- 测量指标: MADRS 总分。
- 起点: 基线评估。
- 时间范围: 第四周评估。
主要终点 回答研究的核心问题; 次要终点 考察其他预先计划的结果。ClinicalTrials.gov 解释了为何必须明确结果指标、测量方式和时间范围。
研究方案还决定研究人员如何比较参与者或组别。单个人的分数变化本身不能证明是治疗造成了这种变化。
研究人员为何使用 MADRS 追踪症状变化
Montgomery 和 Åsberg 于 1979 年发表的论文介绍了一种旨在灵敏反映治疗相关症状变化的量表的开发过程。
MADRS 聚焦于临床医生可以反复评定的特定症状。研究可能考察平均分数变化、达到应答标准的比例或缓解率。每一项都是不同的结果,必须按照研究方案解读。
MADRS 的 10 个条目和总分衡量什么?
MADRS 涵盖特定的情绪、认知和身体症状,并不衡量一个人心理健康或功能状态的方方面面。
MADRS 的 10 个条目评估什么
原版 MADRS 包含:
- 表现出的悲伤
- 自述悲伤
- 内心紧张
- 睡眠减少
- 食欲下降
- 注意力集中困难
- 疲倦乏力或难以开始活动
- 无法感受愉悦或产生情感投入
- 悲观想法
- 自杀意念
例如,睡眠可能发生变化,而注意力的变化幅度并不相同。因此,除了总分,单个条目也很重要。
条目评分如何相加得到 0–60 分的总分
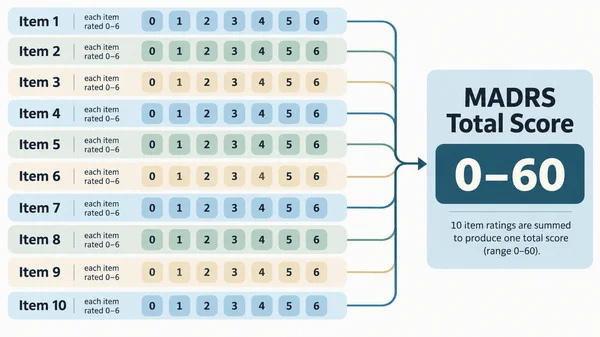
受过培训的临床医生对每个条目按 0 至 6 分评分。各项相加得到 0 至 60 分的总分;分数越高通常表示所测症状越严重。已发表临床研究中的 MADRS 评估方法介绍了这些条目和总分范围。
总分无法显示哪些症状的贡献最大。两个人的总分可能相同,但各条目的表现不同。
MADRS 如何施测?临床医生评分与自评
并非所有标有 MADRS 的问卷都采用相同的施测或评分方法。比较在线结果与临床研究时,这一区别很重要。
临床医生如何施测原版 MADRS
原版 MADRS 由临床医生评分。受过培训的专业人员开展评估,考虑受评者报告的症状和相关观察,并根据量表指南评分。
研究可能采用标准化访谈、评分人员培训及既定的远程评估程序,以提高一致性。
MADRS-S 与在线评估:重要区别
MADRS-S 是一项独立的九条目自评量表,并非由受评者独立完成的原版十条目量表。其条目内容和评分方法有所不同,详见一项已发表的 MADRS-S 心理测量学研究。
| 评估形式 | 谁提供评分? | 主要区别 |
|---|---|---|
| 原版 MADRS | 受过培训的临床医生 | 十个由临床医生评分的条目 |
| MADRS-S | 问卷填写者 | 独立的九条目自评工具 |
| 在线 MADRS 问卷 | 数字问卷填写者 | 是否等效取决于具体实现方式和支持性验证 |
MADRS.net 将其工具描述为十道在线问题并即时评分。这一功能描述不能证明其经过临床验证。在线分数不能自动视为等同于受过培训的临床医生评分或经过验证的试验终点。
关键要点: 比较结果之前,应确认量表版本和施测方法。
研究如何解读 MADRS 变化、应答和缓解?
试验通常相对于起点评估变化。解读这种变化时,需要同时关注个人分数和研究组之间的比较。
基线、绝对变化和百分比下降
基线 是起始测量值。 绝对变化 是随访分数减去基线分数; 百分比下降 是下降值除以基线值,再乘以 100。
请看以下虚构示例:
| 测量指标 | 示例值 |
|---|---|
| 基线 MADRS 分数 | 32 |
| 随访 MADRS 分数 | 16 |
| 绝对变化 | −16 分 |
| 百分比下降 | 50% |
这表示下降了 16 分,即下降 50%。它记录了所测症状的变化,并不能证明已经康复或治疗有效。
应答与缓解:各研究的定义不同
研究可能用相对于基线的百分比下降定义 应答,用较低的绝对分数定义 缓解。应查看实际研究方案,不要假定同一定义适用于所有研究。
例如,一项 2025 年随机临床试验将 MADRS 应答定义为下降至少 50%,将缓解定义为总分 不高于 10 分,并汇总每次访视的比例。其他方案可能采用不同定义。上述从 32 分降至 16 分的虚构示例符合应答标准,但未达到该缓解阈值。
为什么组间差异很重要
假设一项虚构研究报告 A 组 MADRS 平均变化为 −12,B 组为 −8。平均变化的差值是 −4 分,而不是 −12 分。两组均有改善;问题在于两组差异是否可信且有意义。
研究人员会结合预先设定的统计分析评估不确定性,例如置信区间。对于虚构的 −4 分差异,−6 至 −2 的区间不包含零;−7 至 +1 的区间包含零,在该分析中与没有差异的情况相容。后者并不能证明两种治疗等效。这些区间是教学示例,并非根据研究计算出的结果。
即使差异具有统计学显著性,也不一定意味着日常生活中有重要变化。虚构数字不能证明真实的治疗获益。在实际试验中,报告的估计值可能针对基线分数及其他预先设定的因素进行了调整,而非简单地将原始平均值相减。
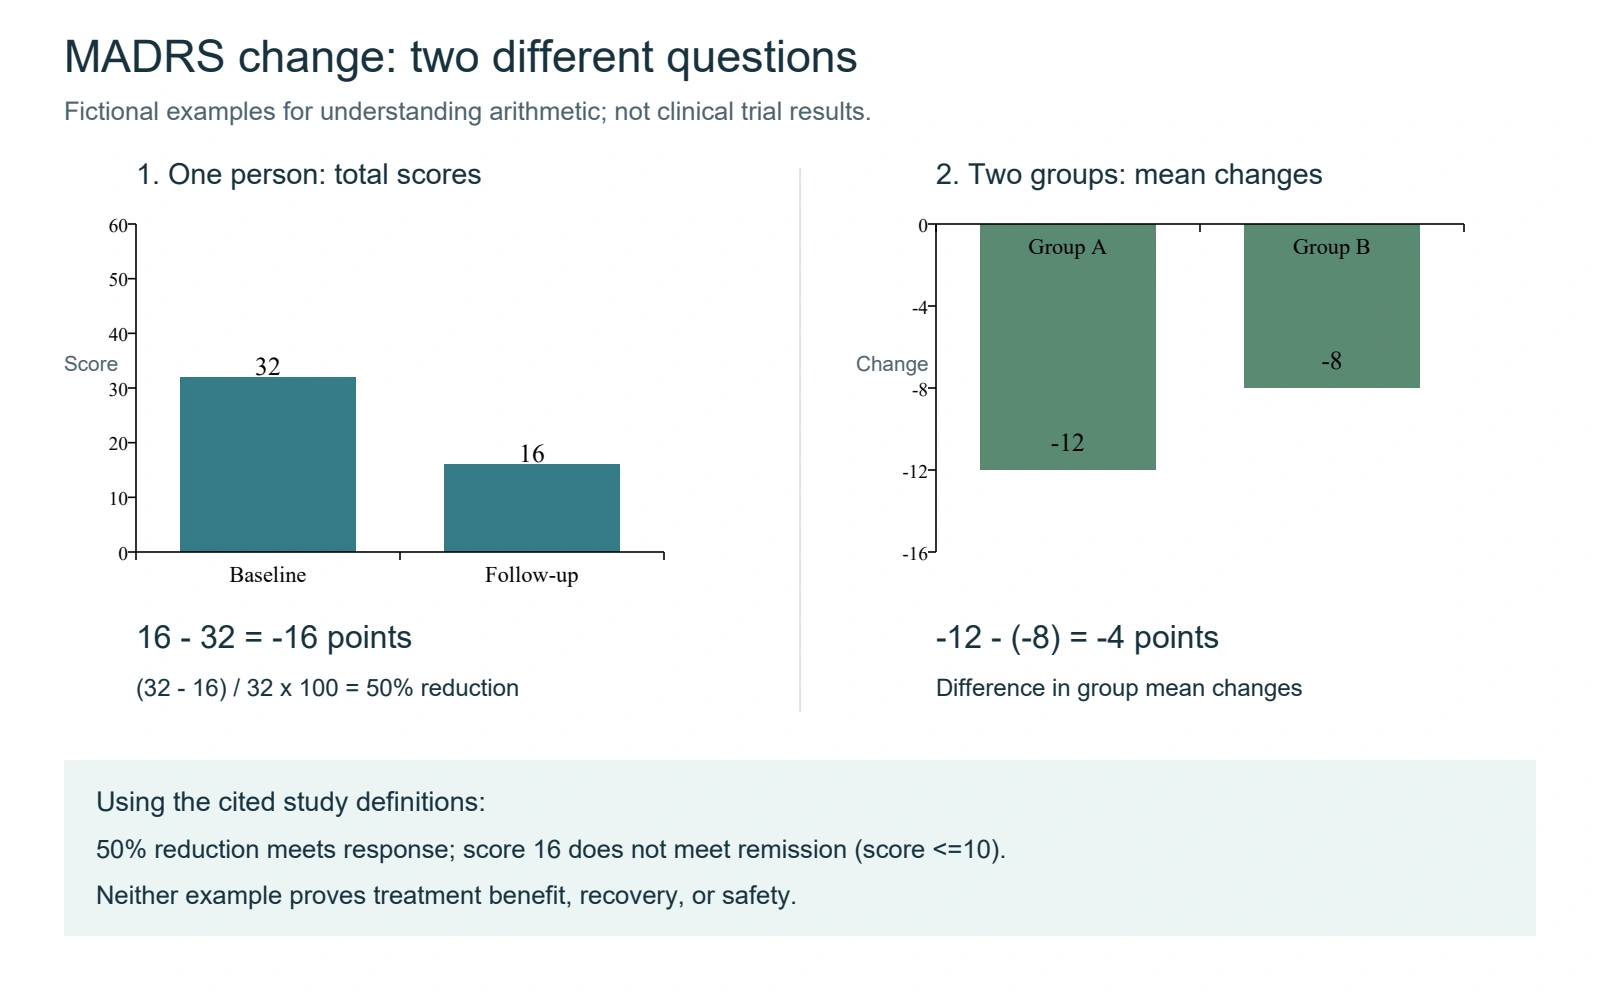
虚构的算术示例。下降 50% 符合所引用的应答定义;随访分数为 16 不符合其不高于 10 分的缓解阈值。
阅读 MADRS 试验结果的清单
解读标题之前,请检查:
- 终点和访视: 结果是计划的主要终点、次要终点,还是探索性分析?它描述的是哪次访视?
- 量表和评分人员: 使用了哪个 MADRS 版本,如何施测,评分人员是否受过培训且对治疗分配保持盲态?
- 对照: 结论基于与安慰剂或另一种治疗的差异,还是仅基于一组内部的变化?
- 估计值和不确定性: 组间差异及置信区间是多少?估计值经过调整还是未调整?
- 缺失数据: 有多少参与者接受了随访评分,其他人为何退出,分析缺失结果时使用了哪些假设?
- 意义和持续时间: 应答和缓解如何定义,改善是否持续?是否单独报告功能状态和安全性?
所引用随机试验的方法提供了报告评分人员、终点时间、分析人群和重复测量模型的示例。单一分数或百分比无法回答所有这些问题。
如何了解 MADRS 分数而不过度解读?
几个实际问题有助于你审慎解读评估结果。
在得出结论之前,请检查:
- 评估方法: 临床医生访谈、经过验证的自评量表,还是在线问卷?
- 比较方式: 是一次评估,还是在相对一致的条件下进行的多次测量?
- 更广泛的背景: 日常功能、压力、睡眠、身体健康或生活处境是否发生变化?
较低分数可能反映所测症状有所改善,但日常生活中仍可能存在重大困难。
与临床医生沟通时,可使用与医生讨论 MADRS 结果指南中的就诊准备清单。带上症状史、日常生活中的困扰以及评估方法;在线总分不是临床诊断。
研究显示 MADRS 症状变化和评分有哪些特点?
已发表的研究说明,为什么总分、条目模式和评估方法都值得关注。
为什么 MADRS 条目模式可能不同
在 Borentain 及同事 2022 年的分析中,研究人员考察了两项针对治疗抵抗性抑郁症成年患者的随机试验数据。事后因子分析识别出三组症状:
- 情感与快感缺失: 表现出的悲伤、自述悲伤、疲倦乏力和无法感受情感。
- 焦虑与植物神经症状: 内心紧张、睡眠减少、食欲下降和注意力集中困难。
- 绝望感: 悲观想法和自杀意念。
研究在 esketamine 试验期间考察了这些组别的变化。组内改善并不意味着每个因子在每次访视时都相对于对照组表现出统计学显著优势。该分析属于探索性分析,未针对多重比较进行调整,且由 Janssen 资助。不应假定这些因子是适用于所有人群的通用分量表。
远程评分揭示了哪些测量局限
Capodilupo 及同事(2024)分析了两项治疗抵抗性抑郁症 III 期研究方案中 733 名参与者远程收集的 MADRS 条目变化趋势,并调查了 75 名评分人员。
睡眠减少是访视间分数变化率最高的条目之一,而评分人员认为自述悲伤在评估变化时尤其有用。观察到的条目变化与感知到的实用性并不完全一致。该研究比较了这些排序;它没有建立通用的症状重要性等级,也没有证明治疗有效。
这并不意味着远程评分本身不可靠。它说明测量程序、受过培训的评分人员和研究背景为何重要。
MADRS、HAM-D 与 PHQ-9:哪些区别重要?
MADRS、Hamilton 抑郁评定量表(HAM-D)和患者健康问卷-9(PHQ-9)都涉及抑郁症状,但形式和评分方法不同。
| 特征 | MADRS | HAM-D | PHQ-9 |
|---|---|---|---|
| 常见形式 | 临床医生评分 | 临床医生评分 | 自评 |
| 常用版本 | 10 个条目 | 17 个条目 | 9 个条目 |
| 主要用途 | 测量严重程度和变化 | 严重程度和治疗结果 | 症状筛查和监测 |
| 关键考量 | 评分一致性 | 症状覆盖范围和评分不同 | 依赖受访者报告 |
临床医生评分的 MADRS 和 HAM-D
两种工具在研究中都有既定用途,但评估症状及赋予权重的方式不同。NIDA 对 HAM-D 的介绍解释了其基于访谈的评分和 17 个变量。因此,MADRS 总分不能直接替代 HAM-D 总分。
MADRS 与 PHQ-9 自评形式
PHQ-9 使用九个自评条目,详见其原始验证研究。原版 MADRS 评分依赖受过培训的临床医生。两种形式不能天然互换。
实用要点: 应使用各工具自身的评分和解读框架,而不是对原始总分进行数值比较。
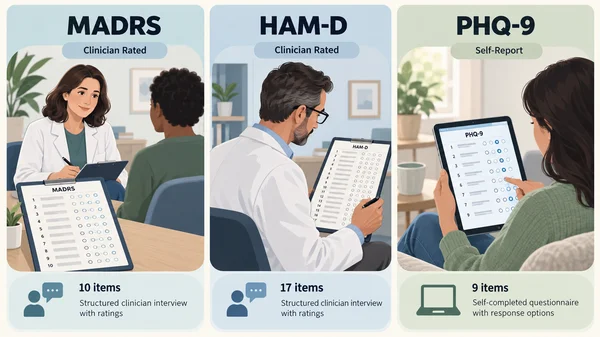
图中的表格仅为示意,并非经过验证的问卷。实际施测取决于具体工具和研究程序。
MADRS 作为临床终点有哪些局限?
标准化症状分数可以支持研究,但无法代表心理健康或日常生活的所有方面。
为什么总分需要结合临床和功能背景
MADRS 不能全面评估工作、人际关系、身体健康或整体功能状态。相同的总分可能掩盖不同症状,分数下降也不意味着每个重要问题都已解决。
评分人员、环境和时间如何影响解读
关键考量包括:
- 方法: 临床医生评分和自评分数并不自动等效。
- 时间: 不同访视之间的症状和处境可能不同。
- 评分人员: 培训和访谈程序会影响一致性。
- 人群: 一个研究人群的结果可能无法推广到另一个人群。
避免三个常见错误:将严重程度标签当作诊断、把每次分数下降都视为治疗成功的证明,以及在未核查分数取得方式的情况下比较不同工具的总分。
如果症状持续、加重或影响日常生活,可考虑咨询合格的医疗专业人员。本文和所链接的在线问卷仅供了解信息和自我认识,不能用于诊断、治疗决策或独立衡量治疗效果。
MADRS 包含一个关于自杀意念的条目。 无论总分多少,安全问题都很重要。 如果你感到自己有立即伤害自己的危险,请寻求紧急帮助或联系所在地的危机服务机构。
结合背景解读 MADRS 变化
MADRS 帮助研究人员量化特定抑郁症状。预先设定的临床终点赋予这些分数在研究中的特定作用;研究设计和治疗组比较决定如何解读结果。
请区分:基线是起点,变化是测得的差异,应答和缓解采用不同标准,而一个人自身的变化并不等同于已证实的治疗组间差异。
如需进一步阅读,请浏览 MADRS 教育资源合集。有关症状或治疗的问题,请咨询合格的专业人员。
常见问题
MADRS 评分 40 分算严重吗?
根据一项已发表的分类,MADRS 评分 35 分或以上 属于严重症状范围,因此 40 分符合该类别。提出这一界值的研究是初步研究,样本量较小。其他方法使用不同界限;任何单一界值都不能提供诊断。
没有临床医生能完成 MADRS 吗?
原版十条目 MADRS 由临床医生评分。MADRS-S 是独立的九条目自评量表,数字问卷也可以独立完成。它们的总分不应自动视为等同于临床医生评分。
MADRS 分数下降 50% 意味着缓解吗?
不意味着。下降至少 50% 符合上述试验的 应答 标准。 缓解 取决于研究规定的绝对分数阈值和时间。按照这一定义,从 40 分降至 20 分属于应答,但如果阈值为 10 分或更低,则不属于缓解。
在线 MADRS 分数可以用作临床试验终点吗?
不能自动如此认定。研究人员必须在预先确定的方案下使用合适的工具和施测方法,并有证据支持其针对该用途的测量特性。仅凭在线工具的数值分数不能证明其适合临床试验。
为什么两个人的 MADRS 总分相同,症状却不同?
总分由十个条目评分相加得出。睡眠和食欲条目评分较高的人,可能与悲伤和注意力困难更明显的人总分相同。条目层面的细节提供了总分无法体现的背景。
临床试验中多久测量一次 MADRS?
时间安排取决于研究方案。有些研究在数周内进行一次基线评分和多次随访评分;另一些采用不同间隔。没有适用于每项试验或每个人的通用时间表。